「這段是 AI 寫的,我看過了,應該沒問題。」在一般軟體公司,這句話的代價可能是一個要回滾的版本。在醫療軟體公司,同一句話可能出現在一個劑量計算模組、一個警報邏輯,或一份送審文件的設計說明裡。AI 代理讓寫程式的速度翻了好幾倍,但醫療軟體的審查、驗證與可追溯性要求,一項都沒有變少。
最近聽了 Lauren Tan 在 2026 年 11 月 AI Engineer 大會上的演講〈All Code Is Slop (Except Mine)〉,她分享了團隊讓大量 AI 代理一起開發一個 Electron 桌面應用、卻沒讓程式碼品質崩壞的做法。演講的場景不是醫療軟體,但裡面的核心觀念:用確定性的約束取代文字告誡,把力氣花在驗證而不是審查,剛好是醫療軟體團隊最熟悉、也最需要的思維。這篇整理演講重點,再翻成醫療軟體開發團隊用得上的版本。
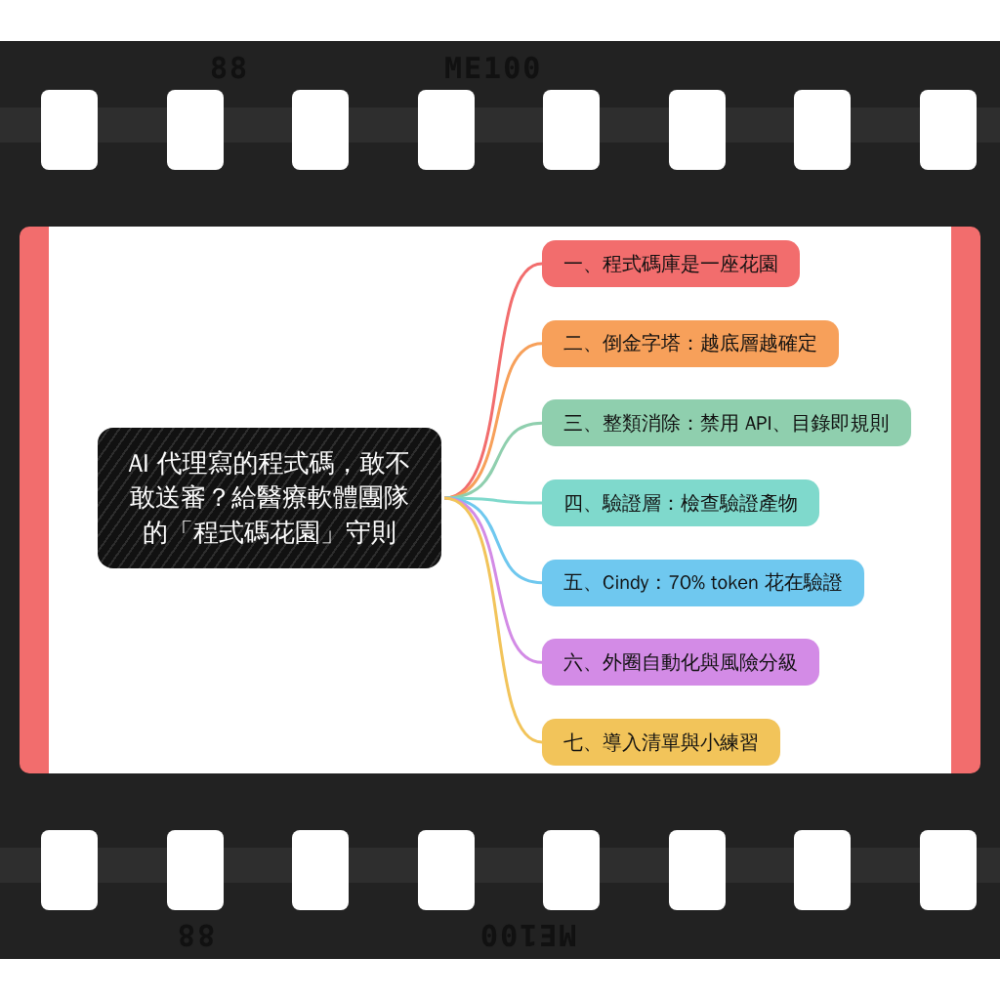
程式碼庫是一座花園:AI 會複製你種下的一切
Tan 用一個數字開場:2024 年,她進辦公室要審的大概是同事寫的 3 個 PR;現在,這個數字比較接近 300 個。她提到團隊在 10 月約有 227 人貢獻過至少一個 PR,送進正式環境的 PR 約 11,000 個,她自己上個月就送了約 3,000 個。
在這種流量下,她把程式碼庫比喻成一座花園。AI 代理依據輸入產生輸出,而整個開發環境裡最大、最有份量的輸入,就是現有的程式碼本身。程式碼庫裡的臨時解法、反模式、過時寫法和技術債,很可能被下一個代理當成「團隊認可的寫法」照抄,然後像雜草一樣擴散到各個模組,速度比人工 code review 發現得還快。
放到醫療軟體,這個比喻更讓人緊張。假設某個模組為了趕上市,用了一個繞過單位換算的寫法、或是在某處直接把例外吞掉。過去這只是一個待還的技術債;在 AI 代理大量產出程式碼的時代,它可能在幾週內被複製到十幾個地方,而且每一處都需要在風險分析、驗證與可追溯性文件裡被重新交代。花園裡的雜草,在醫療軟體裡會長成稽核發現事項。
倒金字塔:越底層越確定,越值得投資
要從「不敢讓 AI 合併程式碼」走到「放心讓自動化跑」,Tan 提出一個信任金字塔。越底層越確定、越能重複驗證,應該優先投資;越上層越依賴判斷,越應該少用:
| 層級 | 演講中的做法 | 醫療軟體團隊可以這樣對應 |
|---|---|---|
| 1. 確定性的程式碼與架構 | 好的 API 設計、架構、重構 | 用型別表達劑量單位、病人識別碼,讓錯誤的組合根本編譯不過 |
| 2. 靜態與確定性檢查 | Lint、型別系統、編譯器、各種自動化測試 | 把每一條「不准這樣寫」的規則寫成 lint 或架構測試,納入 CI |
| 3. 驗證層 | 執行期驗證與形式化驗證 | 警報與狀態機用模型檢查、計算邏輯用屬性測試,產物進入設計歷史檔案 |
| 4. 自然語言指令 | 規則檔、技能、AGENTS.md | 寫給 AI 的開發規範仍需要,但只能當最後一道防線 |
重點在第二層的一個習慣:每當 AI 犯了一個錯,與其在規則檔裡多寫一段「請不要這樣做」,不如把它變成一條會讓建置失敗的檢查。文字告誡沒辦法被強制執行,AI 在複雜情境下仍可能忽略;lint 規則每次都會執行,而且結果可以重現。這句話對醫療軟體團隊特別有感:稽核員要看的從來不是「我們有提醒過」,而是「系統如何確保它不會發生」。
三個把問題「整類消除」的實例
1. 直接禁用容易誤用的 API
Tan 的團隊為自家應用打造了一個名為 Dune 的客戶端框架。他們發現 AI 代理很常把 React 的 useEffect 寫成反模式,於是乾脆在產品程式碼裡禁用它,只允許在 Dune 框架內部的少數地方使用。問題不是被「更小心地審查」,而是被整類消除:審查時再也不用檢查它有沒有被誤用。
醫療軟體的版本:找出你們系統裡「需要很細膩才能用對」的地方,例如浮點數做劑量運算、時區與時間戳記、直接讀寫病歷資料的低階介面。把它們封裝在少數經過完整驗證的模組裡,其他地方用 lint 禁止直接使用。這也剛好呼應 IEC 62304 依軟體安全等級(Class A、B、C)分級管理的精神:高風險邏輯集中在少數單元,驗證的力氣才集中得起來。
2. 讓目錄結構本身就是規則
Electron 應用分成主程序與渲染程序,AI 代理常把兩邊的程式碼混用,造成介面卡頓。團隊的做法很單純:兩邊各放在一個頂層目錄,再用相依性分析工具禁止跨界匯入。違規的程式碼在建置階段就被擋下。
醫療軟體的版本:把安全等級不同的軟體項目放在不同目錄,例如 clinical-core/ 放 Class C 的計算與警報邏輯,ui/ 放顯示層,再用相依性規則規定 UI 只能透過定義好的介面呼叫核心,不能直接碰核心內部。這種隔離本來就是 IEC 62304 架構設計裡要說明的「軟體項目之間的分隔」;把它寫成會讓建置失敗的規則,設計文件裡的那一段就不只是文字,而是有程式碼與 CI 紀錄可以佐證的事實。
3. 關掉「寫註解自我合理化」的逃生口
演講裡最有意思的案例:VS Code 的命令式風格和 React 的宣告式風格發生衝突時,AI 代理會用 setTimeout、requestAnimationFrame 這類計時器當速修,再寫一大段註解解釋為什麼這樣是合理的。速修被下一個代理照抄,計時器越來越多,效能越來越差。團隊的回應很激進:禁止約 99% 的程式碼註解(因為註解很容易過時),並用 lint 規則搭配清楚的錯誤訊息,逼 AI 去解決根本原因。
醫療軟體的版本(請不要直接照抄):醫療軟體的設計理由必須留下紀錄,所以「禁止註解」不能原樣搬過來。可以借用的是背後的精神:不要讓理由只存在於會過時、沒人檢查的註解裡。把「為什麼這樣設計」寫進有編號、有版本、能追溯到需求與風險控制措施的設計文件;程式碼裡只留需求或風險項目的編號。至於計時器、重試、吞掉例外這類「速修」,可以直接用 lint 禁止,要用就得走例外申請與審查。
驗證層:從「逐行審查」到「檢查驗證產物」
Tan 提到,團隊的人工審查重點已經從逐行讀程式碼,轉向檢查自動產生的驗證產物。他們使用的方法包括:
- 執行期驗證:讓 AI 代理能自己執行和除錯應用程式,並維護一份從使用者角度整理的「功能地圖」,作為人和 AI 共用的詞彙。
- 形式化驗證:用 TLA+ 對跨裝置、跨平台的通知流程做模型檢查;用 Lean 檢查自製的虛擬化列表程式庫不會出現閃爍或跳動(她也說這部分仍在實驗)。
- 屬性測試:講義提到用 Bombadil 這類工具,對 UI 狀態做隨機的邊界測試。Bombadil 是 Antithesis 開源的網頁 UI 屬性測試工具;不過演講逐字稿是機器轉寫,這個名稱我們無法百分之百確認。
- 狀態圖:把狀態機畫出來,讓人可以直接審查使用者視角的狀態轉換與邊界條件。
這一段對醫療軟體團隊幾乎是量身訂做。輸液幫浦的警報、監視器的告警升級、跨裝置的臨床通知,本質上都是狀態機,也都是風險分析裡的重點。過去形式化驗證和大量屬性測試因為成本太高,常常只停在「理想上應該做」;Tan 的觀點是,AI 讓這些驗證的撰寫成本大幅下降,現在反而是軟體測試與驗證的黃金時代。
對醫療軟體來說,驗證產物還有第二層價值:它們可以成為法規要求的客觀證據。IEC 62304 要求依安全等級做軟體單元驗證、整合測試與系統測試,並維持需求、設計、測試之間的可追溯性;FDA 在 2023 年的〈Content of Premarket Submissions for Device Software Functions〉指引中,也依文件等級要求提交軟體需求、設計與驗證確效的相關資料。把模型檢查結果、屬性測試報告、狀態圖都自動連結到需求編號,送審與稽核時才不會變成另一場人工補文件的工程。
Cindy 的轉變:70% 的 token 花在驗證
演講中有一個小故事:團隊裡的工程師 Cindy,六個月前說她沒辦法信任自己的 AI 代理,因為它們一直帶進細微的 bug。現在,她每天的 token 有七成用在驗證,而不是產生程式碼。
這個比例值得醫療軟體團隊停下來想一想。很多團隊導入 AI 工具時,衡量的是「多寫了多少程式碼」;但在醫療軟體裡,寫程式從來不是瓶頸,驗證和文件才是。如果 AI 能用來產生測試、找出邊界條件、整理追溯矩陣、比對需求與實作的落差,它對上市時程的幫助,很可能比幫你多寫幾千行程式碼還大。
外圈自動化:先把內圈顧好
Tan 的團隊現在每次切新版本,系統會自動啟動雲端 AI 代理對整個應用做模糊測試,找到問題後自動修、自動開 PR,甚至自動合併。她提到團隊大約每天切一個穩定版本,PR 被撤回的比例穩定在約 0.5%,而啟動、打字、切換對話等效能都變得更快。她也強調,前提是內圈的程式碼庫夠乾淨、約束夠強;內圈如果是雜草,外圈自動化只會更快地產生更多雜草。
醫療軟體團隊看到「自動合併」可能會皺眉,這很合理。變更必須走受控的變更管理,影響安全等級較高的項目時,還要重新評估風險與驗證範圍。比較實際的借用方式是依風險分級:測試程式碼、內部工具、文件格式這類低風險變更,可以逐步放手給自動化;碰到 Class C 單元、風險控制措施或需求的變更,保留人工核准,但讓 AI 先把影響分析、追溯更新與驗證產物準備好。這也和 FDA 在 2025 年定稿的電腦軟體保證(CSA)指引中,以風險為基礎決定確保活動強度的精神一致;該指引談的是生產與品質系統軟體,例如你們的 CI、測試與追溯工具本身。
醫療軟體團隊的導入檢查清單
以下是依演講觀點延伸整理的清單,可以在下一次 sprint 回顧時拿出來討論:
| 面向 | 問自己 |
|---|---|
| 花園 | 程式碼庫裡哪三個反模式,是你最不希望 AI 複製的?有計畫清掉嗎? |
| 確定性約束 | 上個月 code review 裡重複出現最多次的意見,能不能變成一條 lint 規則? |
| 架構隔離 | 不同安全等級的軟體項目,有沒有用目錄與相依性規則強制分開? |
| 設計理由 | 「為什麼這樣寫」記在可追溯的設計文件裡,還是只存在於註解? |
| 驗證層 | 警報、通知等狀態機,有沒有狀態圖或模型檢查?計算邏輯有沒有屬性測試? |
| 證據 | 驗證產物能不能自動連結到需求編號,直接進入設計歷史檔案? |
| 工具 | AI 編碼工具與 CI 工具在你們的品質系統裡怎麼定位?需要哪種程度的工具確效? |
| Token 預算 | 團隊使用 AI 的時間,有多少比例花在驗證,而不是產生新程式碼? |
一個這週就能做的小練習
打開最近 20 個 PR 的審查意見,找出出現兩次以上的同一類問題,例如「這裡不該直接用 float 算劑量」或「UI 不該直接 import 核心內部」。挑其中一個,寫成一條 lint 規則或架構測試,錯誤訊息裡清楚寫出該怎麼改、對應哪個需求或風險項目。合併之後,把原本寫在 AGENTS.md 或開發規範裡的那段文字刪掉。
這樣你就完成了一次從金字塔頂端往底層的搬移:從「拜託不要這樣寫」,變成「這樣寫就過不了建置」。在醫療軟體裡,這不只是工程品質的提升,也是一份能拿給稽核員看的證據。
資料來源
- Lauren Tan,〈All Code Is Slop (Except Mine)〉,AI Engineer 大會演講,2026 年 11 月。數字與案例依據公開的機器轉寫逐字稿,可能有轉寫誤差。
- Bombadil:Antithesis 開源的網頁 UI 屬性測試工具
- IEC 62304:2006+A1:2015,Medical device software — Software life cycle processes
- U.S. FDA,Content of Premarket Submissions for Device Software Functions(2023)
- U.S. FDA,Computer Software Assurance for Production and Quality System Software(2025 年定稿)
本文整理自上述演講與個人學習講義,並延伸到醫療軟體情境。演講本身的場景是一般桌面應用,不是醫療軟體;文中所有「醫療軟體的版本」、法規對應、檢查清單與小練習,是延伸整理的建議,不是演講原文,也不構成法規諮詢。實際做法請依你們的品質系統與法規顧問意見調整。